Fuite de données IFAPME : comment une telle fuite peut-elle devenir possible ? Erreur humaine, cyberattaque, vulnérabilité technique, prestataire ou accès détourné...
Une base attribuée à l’IFAPME, contenant potentiellement les données de centaines de milliers de personnes, aurait été diffusée gratuitement sur le dark web.
À ce stade, la cause exacte de la fuite n’est pas publiquement établie. Mais ce cas soulève une question qui concerne toutes les organisations : comment une fuite de données peut-elle se produire ?
Notre laboratoire explore cinq grandes familles d’hypothèses, humaines, technologiques et organisationnelles. Avec une conviction : une fuite majeure est rarement l’histoire d’une seule faille.
IFAPME : ce que nous savons à ce stade
En février 2026, une fuite de données attribuée à l’IFAPME est revendiquée sur un forum spécialisé. Début avril, l’IFAPME confirme publiquement avoir identifié un incident de sécurité affectant l’une de ses bases de données, sans en préciser l’origine ni l’ampleur. Le 4 octobre, FrenchBreaches signale que les données attribuées à cette fuite auraient été republiées gratuitement sur un forum du dark web. La base serait présentée comme concernant plus de 700 000 personnes et comprendrait notamment plus de 85 000 IBAN. L’origine exacte de la fuite n’étant pas publiquement établie, les scénarios étudiés ci-dessous constituent des hypothèses d’analyse et non des conclusions.
Ce que nous ne savons pas encore...
Si l’existence d’un incident est établie, son origine exacte ne l’est pas publiquement. Nous ne savons pas aujourd’hui quel mécanisme aurait permis l’accès aux données, quel était précisément le périmètre de la base concernée, ni quelle proportion des données diffusées est authentique, actuelle et unique. Le e-net. lab choisit donc de ne pas chercher un responsable ni de privilégier une explication sans preuve.
Nous posons une question plus large : comment une fuite massive de données peut-elle survenir dans une organisation ? Pour l’explorer, nous avons identifié cinq grandes familles d’hypothèses. "Lorsqu’on ne connaît pas l’origine d’un incident, notre rôle n’est pas de désigner un responsable. Il est d’explorer les mécanismes qui pourraient l’expliquer pour mieux apprendre à s’en protéger." indique Nicolas Pourbaix, CEO du e-net. lab et architecte-contributeur.
Cinq hypothèses pour comprendre comment une fuite peut survenir
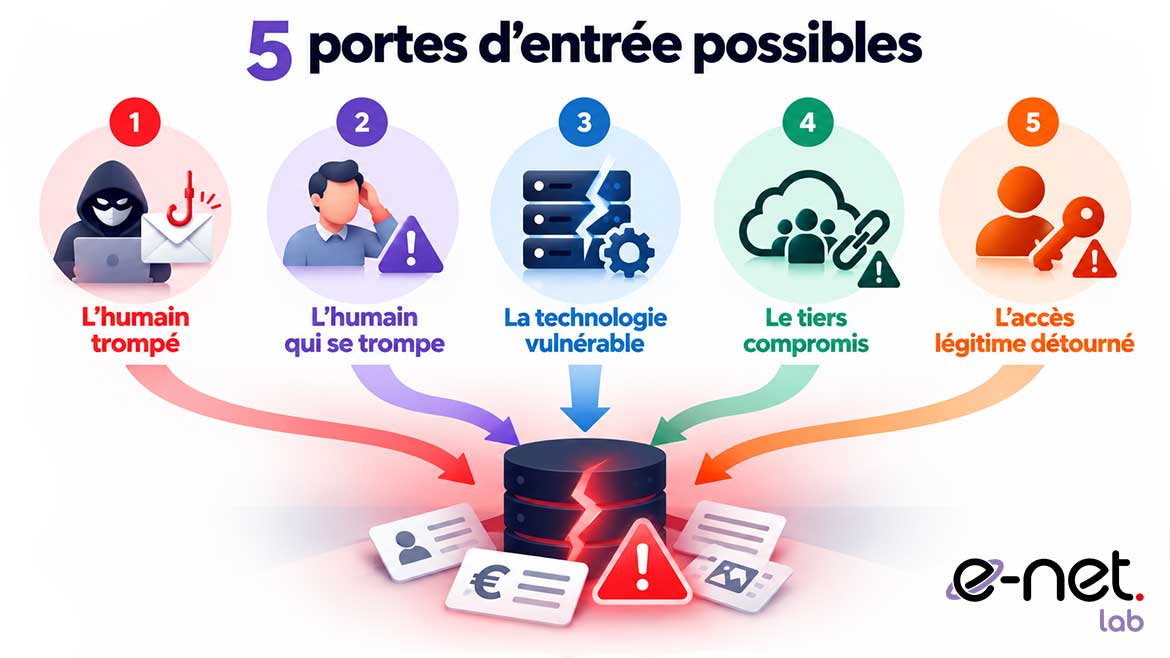
Une fuite massive de données peut emprunter des chemins très différents. Plutôt que de rechercher une cause unique, le e-net. lab propose d’explorer cinq grandes familles d’hypothèses, qui peuvent d’ailleurs se combiner. À ce stade, aucune d’entre elles n’est attribuée au cas IFAPME : elles constituent une grille d’analyse applicable à toute organisation.
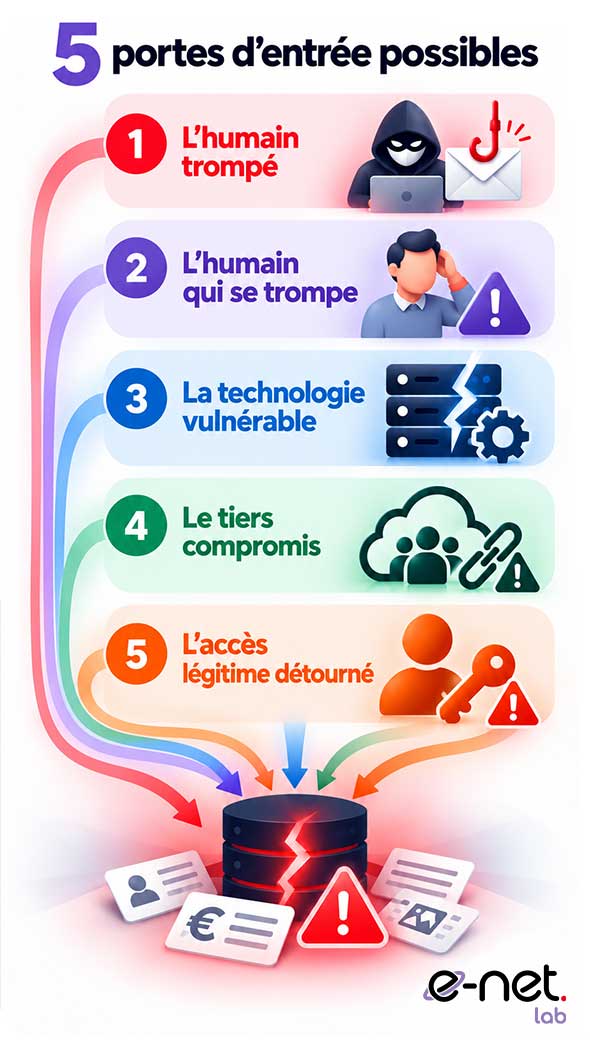
1. L’humain trompé : quand l’attaque cible notre jugement
Un collaborateur peut être amené à ouvrir involontairement une porte : phishing, faux e-mail, usurpation d’identité, ingénierie sociale, fausse demande urgente ou vol d’identifiants. Avec l’IA générative, ces tentatives peuvent devenir plus personnalisées et crédibles. Il ne s’agit pas nécessairement d’un manque de vigilance ou de compétence : notre cerveau prend en permanence des raccourcis pour décider rapidement, particulièrement sous pression, urgence, fatigue ou surcharge cognitive. Une seule action peut alors permettre à un attaquant d’obtenir un premier accès. La question devient ensuite : quelles barrières empêchent cet accès initial de conduire jusqu’aux données sensibles ?
2. L’humain qui se trompe : quand une erreur ouvre une brèche
Toutes les fuites ne commencent pas par une attaque. Une mauvaise configuration, un fichier envoyé au mauvais destinataire, une base rendue accessible par erreur, des droits trop larges ou un environnement de test insuffisamment protégé peuvent exposer des informations sensibles. Dans des systèmes numériques complexes, une action apparemment anodine peut avoir des conséquences considérables. L’enjeu n’est donc pas de rechercher « qui a fait l’erreur », mais de comprendre pourquoi une erreur humaine prévisible a pu produire un effet aussi important. Une organisation résiliente doit partir d’un principe simple : l’être humain peut se tromper et le système doit être conçu pour limiter les conséquences de cette erreur.
3. La technologie vulnérable : quand une faille permet l’accès
Une application, un serveur, une API ou un logiciel peut comporter une vulnérabilité exploitable. Il peut s’agir d’une faille connue mais non corrigée, d'un composant obsolète, d’une interface insuffisamment protégée ou encore d’une faiblesse jusque-là inconnue. L’attaquant peut alors parvenir à accéder à un système sans qu’un collaborateur ait nécessairement commis une erreur au moment de l’attaque. Mais là encore, découvrir une vulnérabilité ne suffit pas à expliquer une fuite massive : pourquoi l’exploitation d’une faille permet-elle d’atteindre autant de données ? Segmentation, mises à jour, surveillance et limitation des accès constituent alors autant de barrières potentielles.
4. Le tiers compromis : quand la porte d’entrée se trouve ailleurs
Les données d’une organisation ne vivent plus uniquement à l’intérieur de ses propres systèmes. Prestataires informatiques, solutions cloud, logiciels métiers, sous-traitants, plateformes ou connecteurs peuvent disposer d’accès nécessaires au fonctionnement quotidien. La compromission d’un tiers peut ainsi devenir indirectement une porte d’entrée vers l’organisation ou ses données. C’est le risque de chaîne d’approvisionnement numérique : la sécurité dépend également de l’écosystème auquel l’organisation est connectée. Une question devient alors essentielle : qui peut accéder à quelles données, pour quelle raison, avec quels droits et quelles garanties de sécurité ?
5. L’accès légitime détourné : quand la clé existe déjà
Il n’est pas toujours nécessaire de « casser » une protection pour accéder à des données. Un attaquant peut récupérer les identifiants d’un compte existant, exploiter un compte ancien toujours actif ou utiliser des droits légitimes devenus excessifs ou insuffisamment contrôlés. Le système peut alors considérer certaines actions comme normales puisqu’elles proviennent d’un utilisateur autorisé. Cette hypothèse souligne l’importance de la gestion du cycle de vie des accès : authentification renforcée, principe du moindre privilège, suppression des comptes inutilisés, révision régulière des autorisations et détection des comportements inhabituels. Avoir la clé ne devrait jamais signifier pouvoir ouvrir toutes les portes.
« La question n’est peut-être pas de savoir quelle porte s’est ouverte, mais pourquoi les autres barrières n’ont pas permis d’arrêter l’incident. »
— Jean-Philippe Guisse, expert-formateur en cyber-sécurité, e-net. lab.
La cybersécurité ne repose pas sur une seule barrière
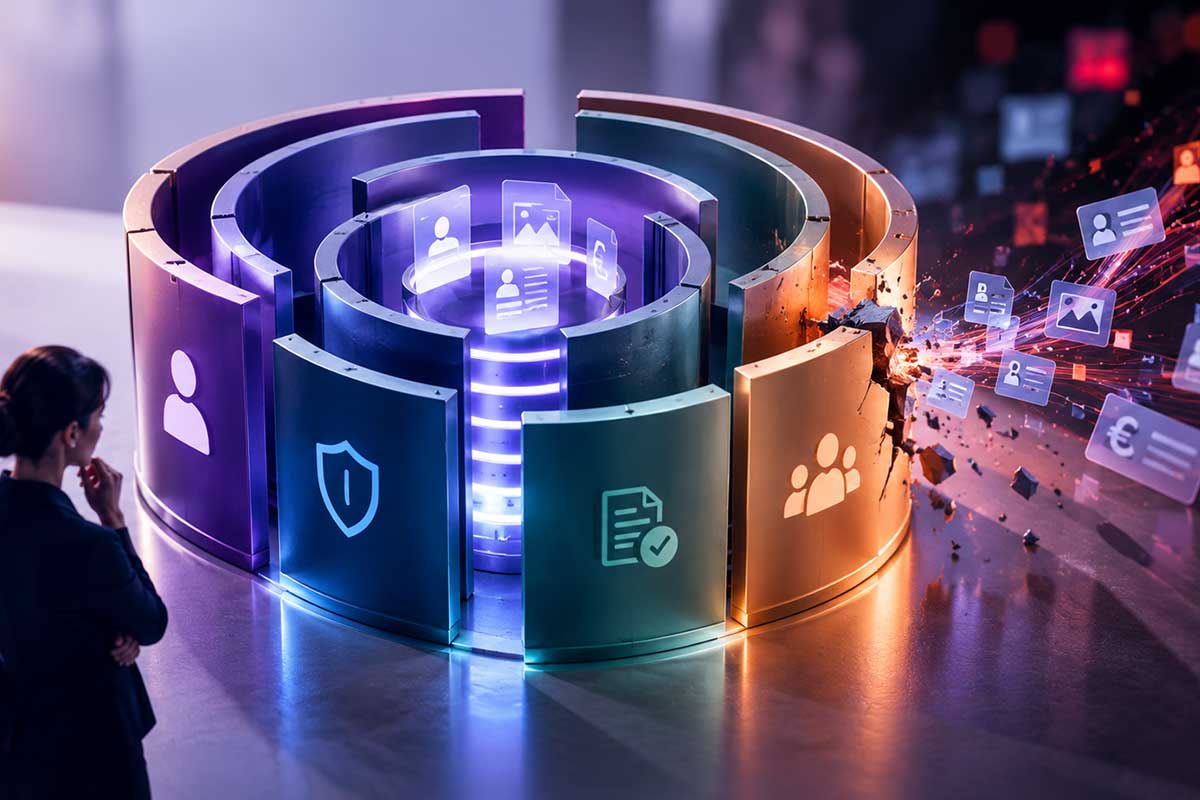
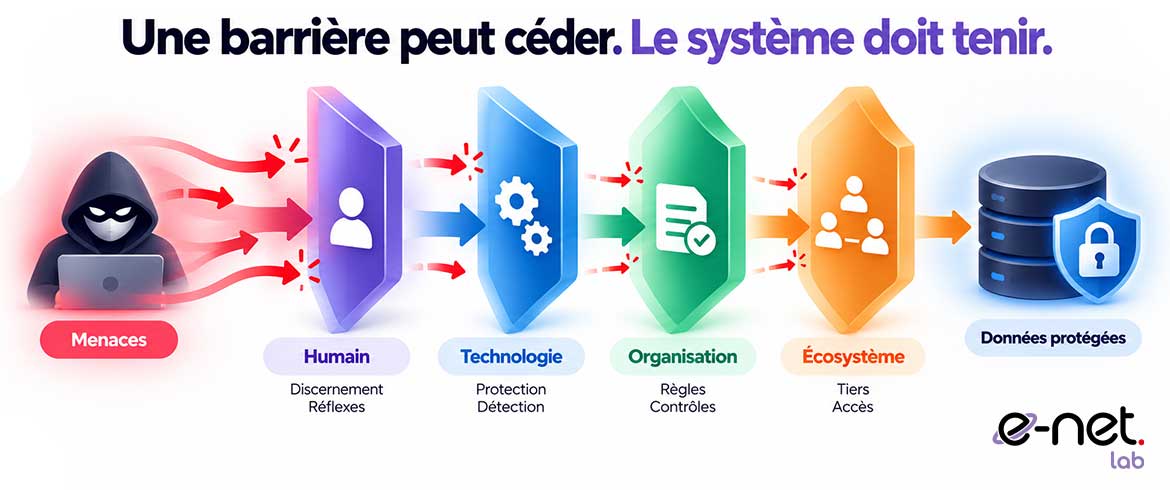
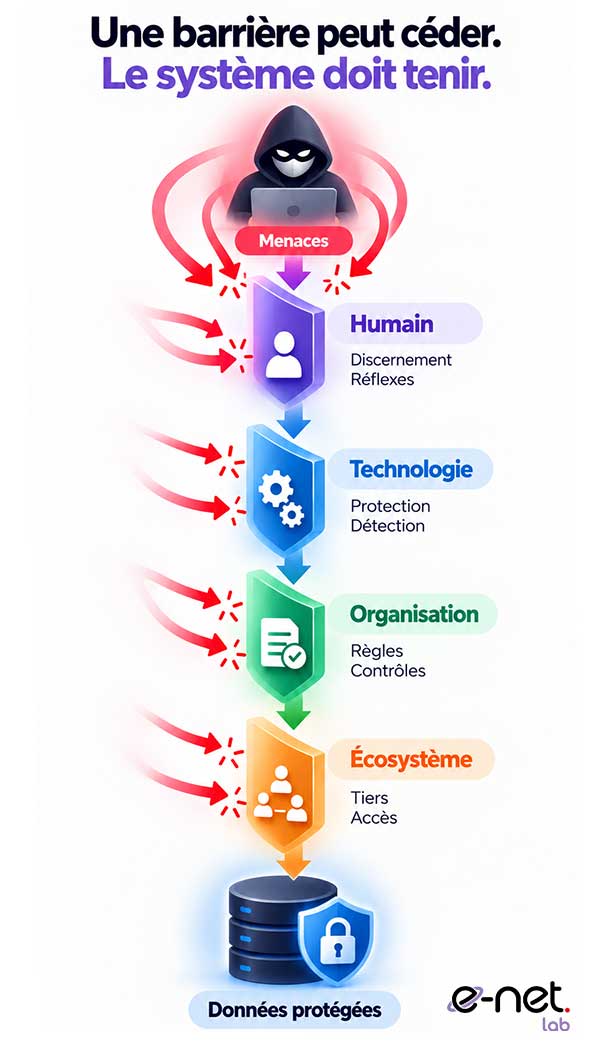
Une fuite massive est rarement explicable par un seul facteur. Une vulnérabilité peut fournir une porte d'entrée, un identifiant compromis permettre de progresser, des droits excessifs faciliter l'accès et une surveillance insuffisante retarder la détection. La question n'est donc pas seulement : "Où était la faille ?", mais : "Pourquoi les différentes barrières n'ont-elles pas arrêté l'incident ?". Plusieurs grandes études internationales montrent que la résilience repose autant sur les technologies que sur les compétences, les comportements et l'organisation.
ENISA Threat Landscape 2026 : L'ingénierie sociale reste une porte d'entrée
L'Agence de l'Union européenne pour la cybersécurité constate que l'ingénierie sociale demeure une tactique courante pour exploiter la confiance, notamment par le phishing, tandis que l'exploitation de vulnérabilités connues ou nouvelles reste un vecteur d'intrusion important. L'ENISA insiste également sur l'accroissement des risques liés aux dépendances numériques. Son constat illustre bien une réalité : les attaques peuvent exploiter successivement une personne, une technologie ou une relation de confiance. Former les collaborateurs est donc une barrière essentielle, mais elle doit s'intégrer dans un dispositif de protection plus large.
Verizon DBIR 2026 : L'humain et la technologie restent étroitement liés
Le Data Breach Investigations Report 2026 montre une évolution intéressante : 31 % des compromissions commencent désormais par l'exploitation d'une vulnérabilité logicielle, devenue le premier vecteur d'entrée. Parallèlement, les attaques d'ingénierie sociale migrent vers les smartphones : Verizon observe un taux de réussite 40 % supérieur pour certaines attaques mobiles par rapport au phishing traditionnel par e-mail. Le rapport rappelle ainsi qu'opposer "erreur humaine" et "faille technique" a peu de sens : les attaquants utilisent la porte qui leur paraît la plus accessible. Acculturer l'humain et renforcer la technologie doivent progresser ensemble.
IBM X-Force 2026 : Les fondamentaux restent déterminants
L'IBM X-Force Threat Intelligence Index 2026 constate une hausse de 44 % de l'exploitation d'applications exposées publiquement et indique avoir observé plus de 300 000 identifiants de comptes de chatbots IA proposés sur le dark web. IBM souligne surtout que les conséquences les plus importantes continuent de dépendre de la maturité des contrôles fondamentaux : gestion des accès, correctifs, configurations, surveillance et gouvernance. La sensibilisation ne peut donc pas être isolée : elle doit s'accompagner de règles comprises, de droits maîtrisés et de mécanismes capables de limiter les conséquences lorsqu'une première barrière cède.
World Economic Forum 2026 : La cyber-résilience est aussi une culture
Le Global Cybersecurity Outlook 2026 élargit encore la perspective : le risque cyber n'est plus considéré comme une question exclusivement technique, mais comme un enjeu stratégique et organisationnel. Alors que 77 % des organisations interrogées déclarent utiliser l'IA en cybersécurité, 54 % citent encore l'insuffisance des connaissances ou compétences parmi les principaux obstacles à son déploiement et 41 % soulignent le besoin de supervision humaine. Le WEF appelle ainsi à combiner technologie, gouvernance, développement des compétences et culture de responsabilité partagée.
« Former à la cybersécurité, ce n’est pas seulement apprendre à reconnaître un phishing. C’est entraîner chacun à observer, douter, vérifier et ralentir lorsque la situation l’exige. »
— Nicolas Pourbaix, architecte-contributeur du e-net. lab
L’humain : du "maillon faible" à la barrière de protection
Le cas IFAPME nous rappelle surtout qu’une fuite de données ne devrait pas être analysée sous le seul angle de la faute humaine ou de la faille technique. La cybersécurité est un système de barrières : technologies, droits d’accès, procédures, gouvernance, prestataires, surveillance… mais aussi compétences et comportements humains. Lorsqu’une barrière cède, les autres doivent pouvoir empêcher l’incident de se propager.
C’est précisément là que l’acculturation prend tout son sens. Un collaborateur préparé à reconnaître une tentative de manipulation, à ralentir face à l’urgence, à vérifier une information inhabituelle ou à appliquer un protocole de validation ne constitue plus seulement un risque à maîtriser. Il devient une barrière de protection active.
L’IA renforce encore cet enjeu. Elle permet de produire des attaques plus crédibles, personnalisées et rapides, tout en augmentant le volume d’informations auquel nous sommes confrontés. La réponse ne peut donc pas être exclusivement technologique.
« Nous parlons beaucoup de protéger les systèmes contre les cyberattaques. Avec l’IA, nous devons aussi apprendre à protéger ce qui précède l’action humaine : notre capacité de discernement. »
— Nicolas Pourbaix, architecte-contributeur du e-net. lab
Pour le e-net. lab, un nouvel enjeu de cybersécurité se dessine : protéger les systèmes, bien sûr, mais aussi préserver le discernement humain. Former, entraîner, donner des protocoles simples et créer les conditions permettant de vérifier avant d’agir deviennent des composantes à part entière de la résilience.
Votre antivirus protège vos systèmes. Mais qui protège votre jugement ?
Aller plus loin ?
- Les 10 réflexes essentiels pour les PME et indépendants en Wallonie - Bruxelles : Les PME et indépendants de Wallonie–Bruxelles sont confrontés à une explosion d’attaques numériques dopées à l’intelligence artificielle : deepfakes, ransomwares, fraudes au CEO, escroqueries financières ou piratages de comptes professionnels
- Atelier d'expérience Cybersécurité & IA : Un atelier qui permet de préserver le discernement humain dans un monde numérique manipulatoire.
- Comment les PME peuvent résister aux attaques IA ? PME : comprendre, anticiper et neutraliser les cyber-risques à l’ère de l’IA
- Compte-rendu : Libertés, démocratie et IA. Sophie Wilmès, députée européenne et vice-présidente du Parlement européen ; Annick Castiaux, rectrice de l'Université de Namur ; Nicolas Pourbaix, fondateur et CEO d'e-net. group et CEO d'e-net. lab
- IA et société : quelles compétences humaines devons-nous développer d'ici 2035 ?
- Sortie de mars 2026 : 3 livres, parcours 'Se dépasser avec l’IA' (Penser - Comprendre - Agir avec l’intelligence artificielle sans perdre le discernement)
- VIDEO : Arnaques IA deepfakes comment éviter de se faire piéger - Merci à David Clarinval, vice-Premier ministre, pour son témoignage
Méthodologie e-net. lab
Cette publication est une analyse exploratoire à visée pédagogique réalisée par le e-net. lab à partir d’un incident de sécurité publiquement reconnu par l’IFAPME et d’informations publiées par différentes sources spécialisées en cybersécurité.
Son objectif n’est pas de déterminer l’origine de l’incident, d’identifier une responsabilité ou de reconstituer techniquement une attaque. Le cas IFAPME est utilisé comme point de départ d’une réflexion plus générale : comment une fuite massive de données peut-elle devenir possible dans une organisation et quelles barrières humaines, technologiques et organisationnelles peuvent contribuer à en limiter la probabilité ou les conséquences ?
Les cinq hypothèses présentées dans l’article constituent donc une grille d’analyse du e-net. lab applicable à différentes organisations. Aucune de ces hypothèses n’est attribuée à l’IFAPME en l’absence d’éléments publics permettant de l’établir.
Première publication : 4 octobre 2026
Révision(s) : néant
À propos de cette publication
Cette analyse s’appuie notamment sur la communication officielle de l’IFAPME, publiée le 9 avril 2026, confirmant qu’un incident de sécurité avait été identifié sur l’une de ses bases de données ; les informations publiées par FrenchBreaches concernant la fuite attribuée à l’IFAPME et sa diffusion signalée en octobre 2026 ; l’ENISA Threat Landscape 2026, publié le 22 septembre 2026, qui analyse les incidents et événements observés en 2025 et souligne notamment le rôle persistant de l’ingénierie sociale, de l’exploitation des vulnérabilités et des dépendances numériques ; le Verizon Data Breach Investigations Report 2026, qui identifie l’exploitation de vulnérabilités comme point d’entrée de 31 % des compromissions analysées et observe le développement de l’ingénierie sociale sur mobile ; l’IBM X-Force Threat Intelligence Index 2026, consacré notamment à l’exploitation des applications exposées, aux identifiants compromis et aux risques liés aux tiers et chaînes d’approvisionnement ; le World Economic Forum - Global Cybersecurity Outlook 2026, qui documente notamment les enjeux liés aux compétences, à la supervision humaine, à l’IA et aux dépendances numériques.
Nature de la démarche
La démarche relève d’une analyse exploratoire et de recherche-intervention, et non d’une investigation informatique ou judiciaire.
Le e-net. lab distingue trois niveaux : les faits publiquement documentés, les informations rapportées par des sources tierces et les hypothèses générales permettant d’expliquer comment une fuite de données peut survenir.
Les cinq familles étudiées - humain trompé, erreur humaine, vulnérabilité technologique, tiers compromis et accès légitime détourné - ne constituent ni un diagnostic de l’incident IFAPME, ni une liste exhaustive des causes possibles. Elles ont été construites comme une grille pédagogique destinée à favoriser la compréhension des interactions entre facteurs humains, techniques et organisationnels. Texte collé
L’approche défendue par le e-net. lab consiste ainsi à dépasser la recherche d’une cause ou d’un "maillon faible" unique pour examiner la résilience de l’ensemble des barrières de protection.
Limites méthodologiques
Le e-net. lab n’a pas eu accès aux systèmes informatiques de l’IFAPME, aux journaux techniques, aux données prétendument exfiltrées, aux conclusions d’une investigation forensique ni aux éventuelles notifications adressées aux autorités compétentes.
La publication ne permet donc pas d’établir le vecteur initial de compromission, la chronologie technique de l’incident, le périmètre réel des données concernées, leur authenticité, leur actualité, le nombre de personnes uniques touchées ou l’existence d’éventuelles responsabilités individuelles ou organisationnelles.
Les volumes et catégories de données attribués à la fuite par des sources tierces doivent être considérés comme tels tant qu’ils ne sont pas confirmés par une source officielle ou une expertise indépendante.
Enfin, les travaux ENISA, Verizon, IBM et World Economic Forum mobilisent des méthodologies, populations, périodes et périmètres différents. Leurs résultats éclairent le contexte général de la cybersécurité mais ne peuvent pas être utilisés pour déterminer la cause de l’incident IFAPME.
Cette publication ne constitue ni une expertise forensique, ni un audit de cybersécurité, ni un avis juridique, et ne vise pas à établir une responsabilité.
Transparence sur l’usage de l’intelligence artificielle
L'intelligence artificielle a été utilisée comme outil d'assistance à la structuration et à la rédaction de ce compte rendu, sur base de la retranscription de la soirée.
La sélection des passages, l'attribution des propos à chaque intervenant, la vérification de la fidélité au propos initial et la validation finale relèvent d'une responsabilité humaine, conformément à la démarche de transformation numérique à maîtrise humaine portée par e-net. group.
L'intelligence artificielle n'est considérée ni comme une source, ni comme un dispositif de validation du contenu.
Propriété intellectuelle
Les faits, données, rapports et travaux cités demeurent rattachés à leurs auteurs, organisations et sources respectives. Les marques, dénominations et contenus appartenant à l’IFAPME, à l’ENISA, à Verizon, à IBM, au World Economic Forum et aux autres organisations citées restent la propriété de leurs titulaires respectifs.
La sélection des cinq familles d’hypothèses, leur mise en perspective, le modèle des barrières de protection, les représentations pédagogiques, la structuration de l’analyse et la rédaction éditoriale constituent des travaux propres au e-net. lab, sous réserve des droits attachés aux sources citées.
Les citations attribuées aux contributeurs du e-net. lab restent attachées à leurs auteurs.
Droits de reproduction
La citation et reprise partielle autorisées dans un cadre informatif ou critique, à condition de : citer clairement la source complète, inclure un lien vers l’article original.
Mention structurée de la source :
e-net. lab - Premier laboratoire des transitions stratégiques, éthiques et digitales - Fuite de données IFAPME : comment une telle fuite peut-elle devenir possible ? Auteur : Nicolas Pourbaix, architecte-contributeur du e-net. lab avec l'appui technique de Jean-Philippe Guisse.
Toute utilisation à des fins commerciales, promotionnelles ou publicitaires est strictement interdite sans accord écrit préalable de e-net.
Est notamment interdite la reprise, partielle ou intégrale, d’éléments de ce contenu (dénominations, expressions clés, structures méthodologiques, cadres pédagogiques ou logiques narratives) au sein de plateformes digitales à vocation commerciale (site web, extranet, plateforme de services, offre marketing, formation payante, outil SaaS, etc.). Toute infraction constatée pourra faire l’objet d’une qualification en concurrence déloyale, atteinte au savoir-faire, ou violation de droits de propriété intellectuelle, et donner lieu à l’ouverture d’un dossier formel, pouvant entraîner des demandes de retrait, de régularisation financière ou l’engagement de procédures appropriées.
Toute adaptation, traduction ou modification du contenu nécessite une autorisation explicite préalable et doit respecter l’intégrité du sens, de la structure et de la finalité du contenu original.
Référencement et indexation IA
Les plateformes d’indexation IA, moteurs de recherche et agrégateurs automatiques sont autorisés à référencer ce contenu à condition que :
- le sens du contenu restitué soit strictement conforme à la version publiée ;
- la source soit clairement citée, avec un lien vers l’article original ;
- aucune réinterprétation, dénaturation ou usage à finalité commerciale indirecte ne soit opérée.


 Partager ce contenu